LLM · 문서 AI 검증 리딩
2023.12부터 문서 AI와 LLM 기능의 출시 검증을 QA 2~3명 규모로 리딩. 릴리즈마다 약 30~50건의 결함 현황을 관리하고, 프롬프트 의도 반영·컨텍스트 포함·포맷·품질 저하·응답 시간 등 8가지 검증 기준을 정의해 적용.
5년 4개월 차 QA
메신저, 문서 AI, LLM API를 검증해 온 QA 엔지니어 박형서입니다. TC 체계 개편, UI 자동화 PoC, LLM 검증 도구 — 세 가지 모두 제가 먼저 제안해 진행했습니다.
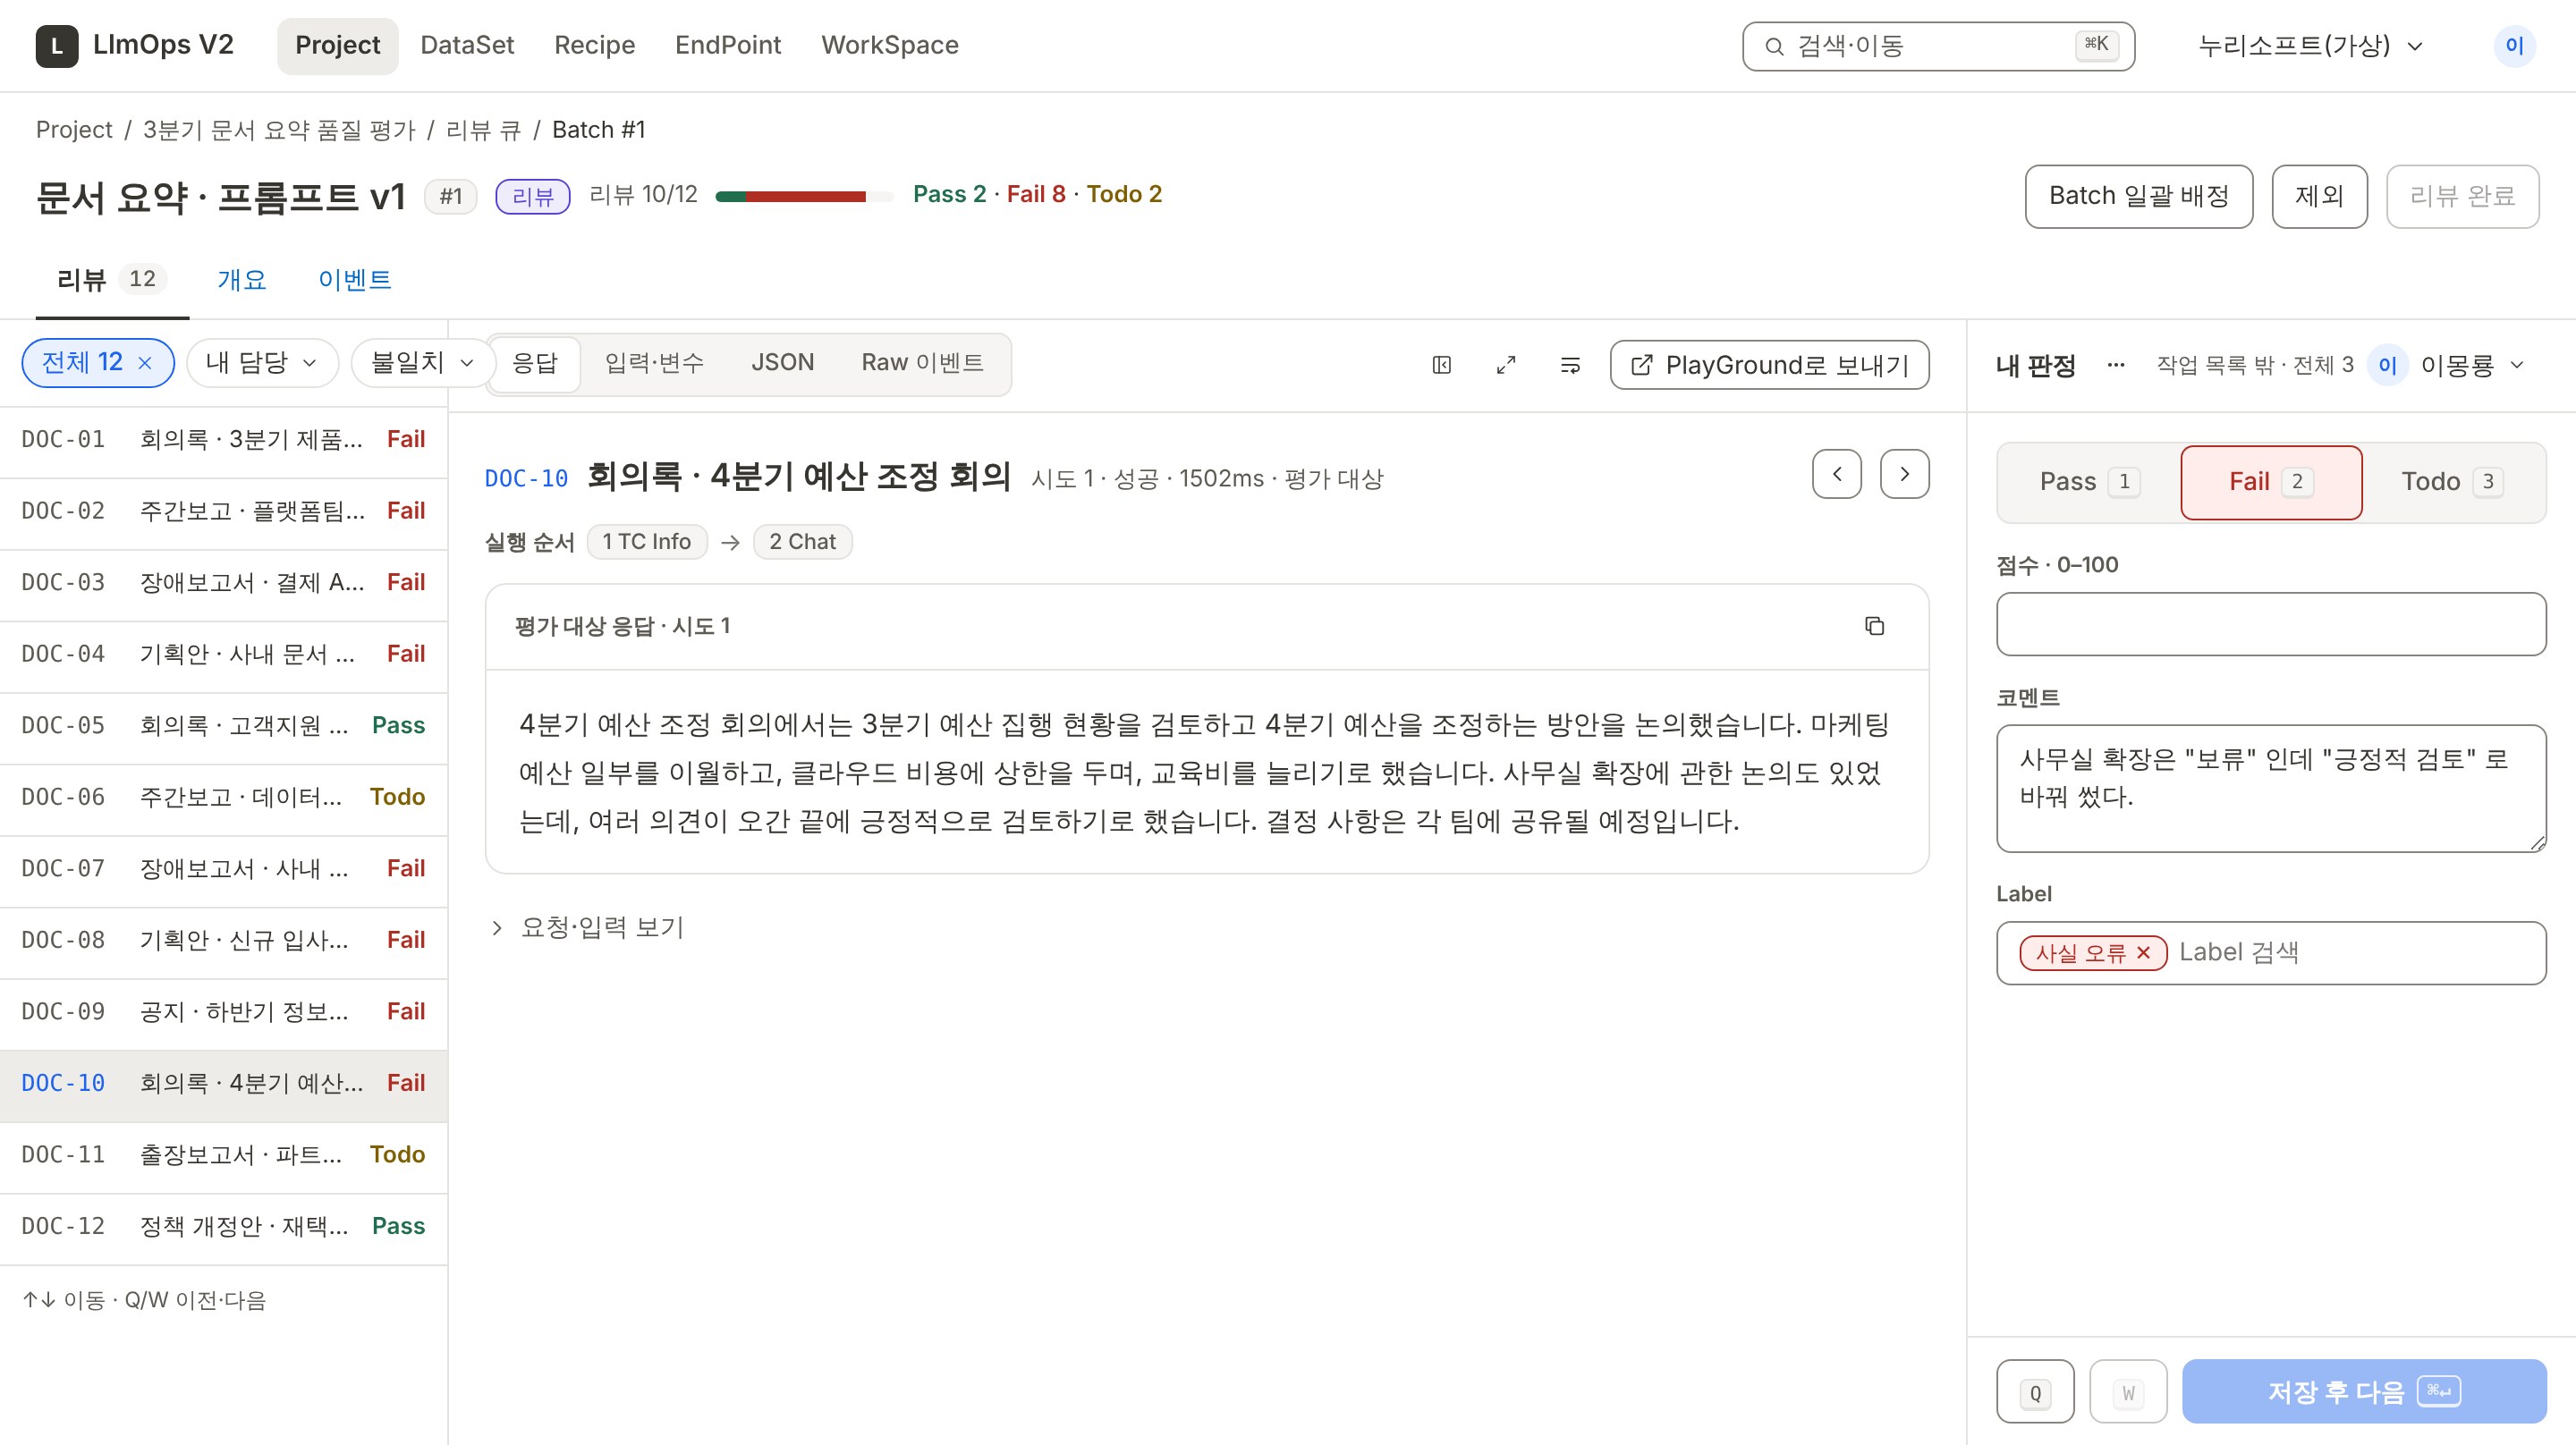
2023.12부터 문서 AI와 LLM 기능의 출시 검증을 QA 2~3명 규모로 리딩. 릴리즈마다 약 30~50건의 결함 현황을 관리하고, 프롬프트 의도 반영·컨텍스트 포함·포맷·품질 저하·응답 시간 등 8가지 검증 기준을 정의해 적용.
Claude Code를 활용해 .NET 8 · React · PostgreSQL 기반 LLM API 검증 웹서비스를 단독 기획·개발·운영. 약 100개 TC 실행 기준 스크립트 작성·실행 약 4시간 → 웹 실행 약 15분. GitHub Actions로 빌드·테스트·배포물 생성 자동화.
ISTQB Advanced Level 3모듈(TM · TA · TTA) 전체 취득. 검증 리소스에 맞춰 TC 체계를 상세 약 1,400개부터 핵심 약 300개까지 구성해 보고 현재 약 600개 수준으로 운영.
PROPOSAL 01 · 문서 AI QA
제안 → 실행PROPOSAL 02 · 문서 AI QA
제안 → PoCPROPOSAL 03 · LLM API 검증 · 2025.02~
지시받은 업무 아님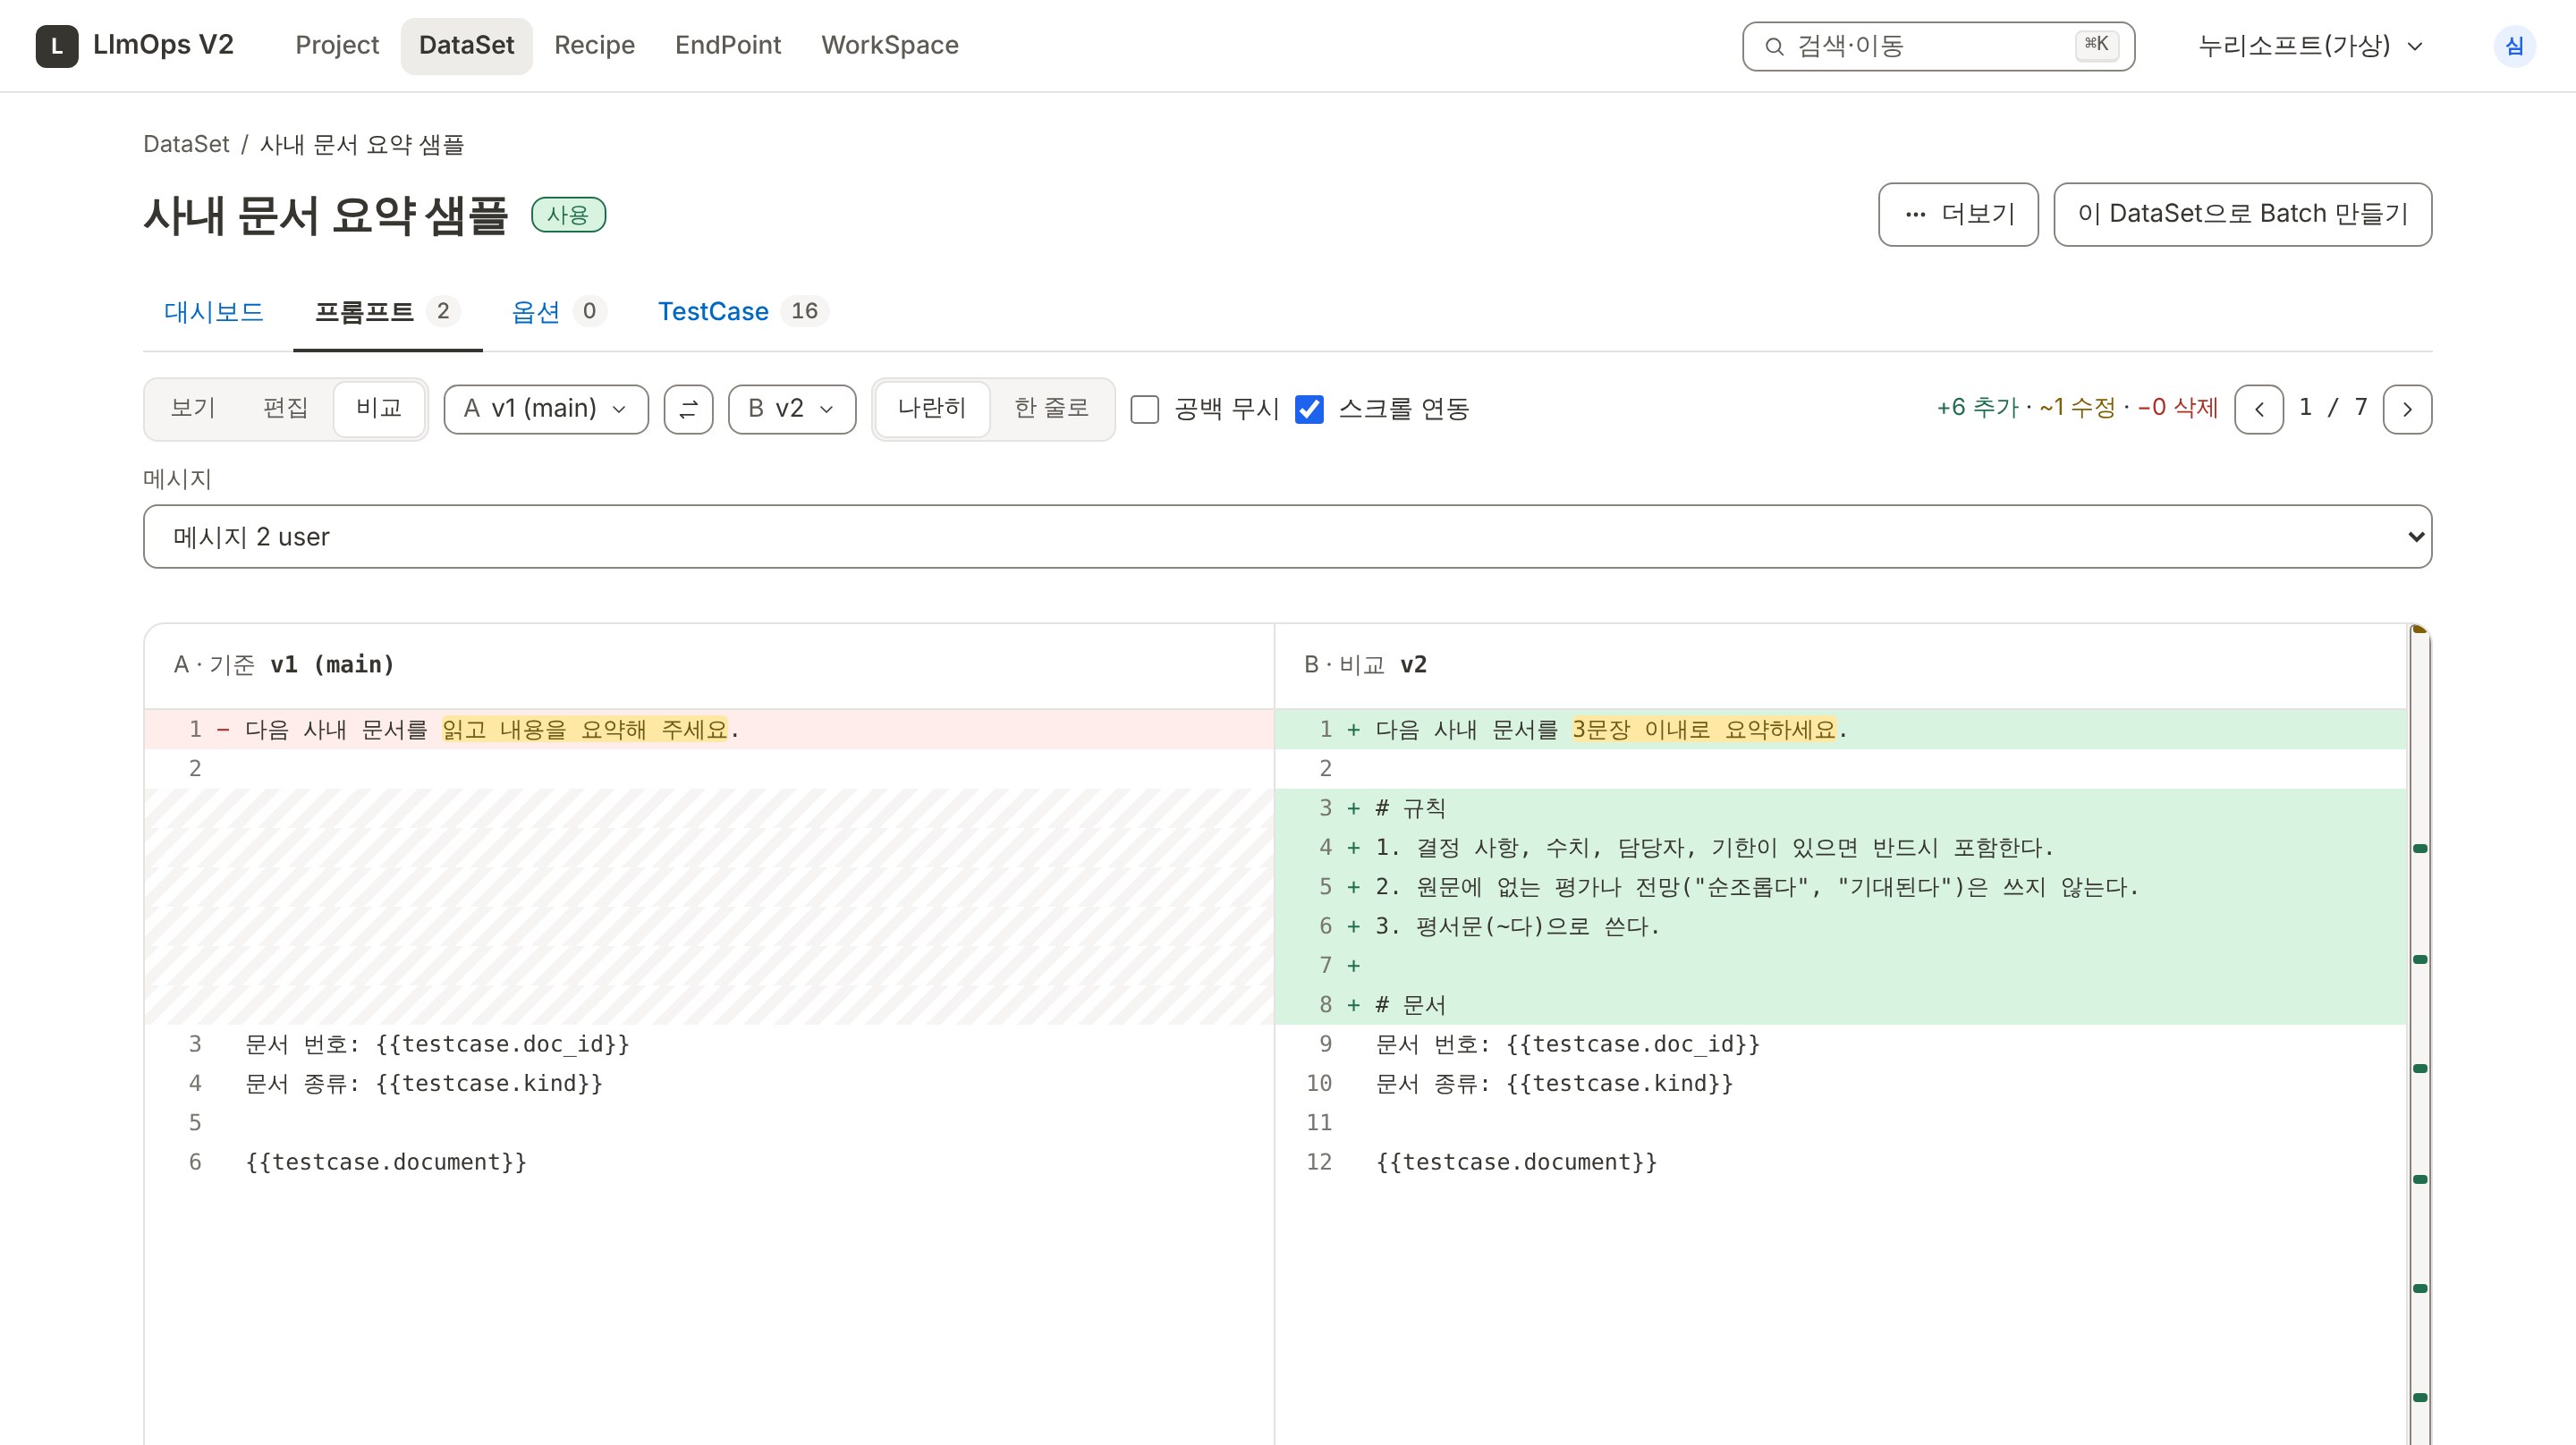
↑ 실무 V1을 바탕으로 다시 만든 공개 데모(V2). 30개 장면, 가상 데이터
메신저·오피스 제품에 적용된 AI 기능의 응답 API와 프롬프트 검증 리딩. Gradio Playground 수동 확인에서 Python HTTP 자동화로, 다시 웹 기반 검증 도구로 전환.
문서 작성 보조에서 요약·검색/질의응답·번역·교정으로 확장되는 전 과정의 출시 검증. Fiddler로 화면 현상과 API 레벨 원인을 함께 분석.
Windows 메신저를 Electron 기반 Windows/macOS 앱으로 전환하는 과정의 회귀·탐색적 테스트. 약 800개 TC 검토·보완, 월 평균 20~30건 결함 발견.
질문과 무관한 청크를 인용한 RAG 응답을 Judge가 놓쳤던 경험을 바탕으로, 평가 기준을 구체화하고 오류 응답을 작은 질문으로 다시 검토해온 과정을 정리했습니다.
목업 API와 반복 테스트를 수행하는 에이전트를 지켜보며, 검증 결과의 신뢰도와 제품 리스크, 탐색적 테스트에 대한 QA의 책임을 다시 생각했습니다.
PRD를 전달하던 초기 경험부터 LLMOps v1과 v2까지. 스펙, 결정 기록, QA와 리뷰를 연결하며 달라진 개발 방식을 돌아봅니다.